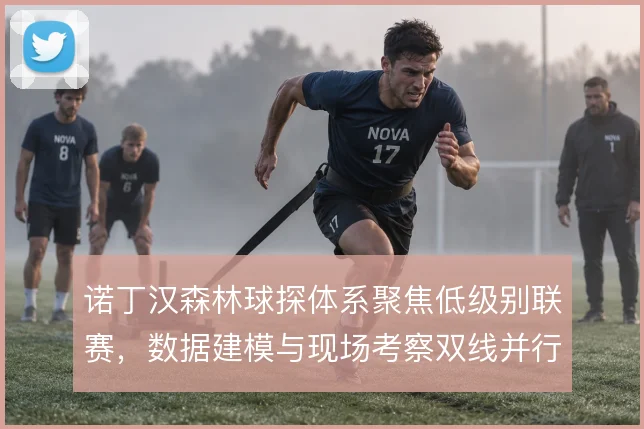
英格兰中部有一家俱乐部把选材网撒得比同级别对手更低。诺丁汉森林的球探部门近几个赛季把大量精力放在英甲、英乙以及全国联赛,而不是和豪门争抢已经成名的年轻人。这条路线背后是一套被拆成两条线的流程:一条线在服务器里跑比赛数据,一条线由球探带着笔记出现在看台角落。两条线最后要在同一张球探报告上签字,署名人不同,看到的画面也往往不同。低级别联赛球员的身价区间、合同年限和出场稳定性,与英超梯队完全不是一回事,这正是森林愿意往里走的理由。
一、把筛选门槛降到英乙
森林的球探名单里,全国联赛球队的边后卫和英乙中场占了相当比例。这些人往往二十出头,已经在成年比赛里踢满过一个赛季,每周面对的是身体对抗和泥泞场地,而不是青年队的教学赛。相比英超梯队球员,他们的比赛样本更接近一线队真实强度,录像里看到的铲抢和回追,到了英冠赛场也不会突然消失。
门槛降低带来的直接后果是竞争对手变少。英甲和英乙的看台上,来自英超的常客并不多,森林的球探因此更容易和主教练聊上几句,问清楚某名球员训练态度如何、伤病史是否反复。这类信息不会出现在公开数据库里,却常常决定一笔几十万英镑的报价要不要发出去。
低级别联赛球员的身价也让试错成本可控。一名英乙主力中场的转会费,可能只相当于英超一名替补门将的周薪,即便最终没能踢上主力,外租到英冠也能收回部分投入。森林并不指望每一笔都成功,而是让失败的那几笔不至于伤筋动骨。
二、数据模型先筛掉一半人
负责数据的一端会先跑一遍基础指标,把出场时间不足、伤病记录密集的球员剔除。留下的名单再按位置分组,边锋看推进距离和一对一成功率,中卫看拦截位置和争顶落点,中场则更关注向前传球的线路选择。这些指标本身不新鲜,难的是把英乙的数据和英超的数据放在同一套坐标里比较。
为了让跨级别的数字可比,森林的建模团队会给不同联赛加权重系数。英甲的进球折算到英冠要打折,全国联赛的助攻折算到英乙也要打折,折扣比例来自过去几个赛季外租球员的实际表现。这套系数并不公开,但球探部门能拿到修正后的排名,用来决定下一站去看谁。
模型跑完只会给出一份短名单,通常每个位置留下三到五人。这些人会被分配到具体的现场球探,每人负责跟两到三场主客场比赛,重点观察的是数据看不到的部分,比如丢球后的第一反应、被换下时的情绪、以及和队友在死球期间的交流。
三、现场笔记和数据打架时
两条线经常给出不一致的结论。数据端可能因为某名边锋的过人成功率排在前列而给出高分,现场球探回来却在报告里写他每次过人之后都不看禁区,传中时机总是慢半拍。这种分歧不会立刻被抹平,而是会被标成待核实项,安排第二次、第三次实地观察。
反过来也有数据吃亏的情况。一名英乙后腰的拦截数字平平,但球探连着看了三场,发现他站位聪明,很多球是靠提前移动化解掉的,根本没有形成抢断动作。这类球员在模型里排名靠后,却在现场报告里被反复提起,最终往往靠球探的坚持进入正式考察名单。
解决分歧的办法是把观察维度拆细。数据端负责回答这名球员过去做了什么,现场端负责回答他在压力下会怎么做,两边的结论合并到同一份报告里,由球探主管决定是否推进。这套流程谈不上精密,但至少避免了单靠一方拍板。
四、双线并行的代价在时间
同时跑数据和现场考察,意味着同一名球员要占用两拨人的工时。数据端需要定期更新联赛样本,现场端则要安排差旅,英乙球队分布在英格兰各个角落,一场周二晚上的比赛,球探可能凌晨才能回到驻地。这些成本不会体现在转会费上,却实实在在消耗部门预算。
时间压力还来自球员本身。低级别联赛里表现突出的年轻人,往往在冬窗就被英冠球队提前锁定,森林如果等到赛季结束再动手,面对的可能是已经涨过一轮的价格。因此数据筛选必须比以往更早启动,现场观察也要在秋季就完成第一轮覆盖。
对森林来说,这套体系真正的产出不是某一笔签约,而是把英甲、英乙和全国联赛纳入了日常视野。当一名球员从这些联赛进入一线队轮换,球探部门就能拿具体比赛片段去校验自己的权重系数,下一次筛人时少犯一次错。
两条线并行的前提是双方都愿意认错。数据模型会在赛季中期根据外租球员的表现调整系数,pg模拟器现场球探也会因为某名球员连续几场的表现推翻自己此前的判断。这种互相修正的过程,比任何一份单独的报告都更接近真实水平。
森林的选材路线并不适合所有俱乐部。阵中已经有成熟主力的球队,更需要的可能是即战力而不是潜力股,而森林现在的位置,允许他们把一部分预算押在英乙和全国联赛的年轻人身上,赌的是其中一两个能在两年后站上英超赛场。这条路能走多远,取决于球探的报告和数据的修正速度,哪一个先跟上对方的节奏。